À la rencontre de... Maroua Bahri
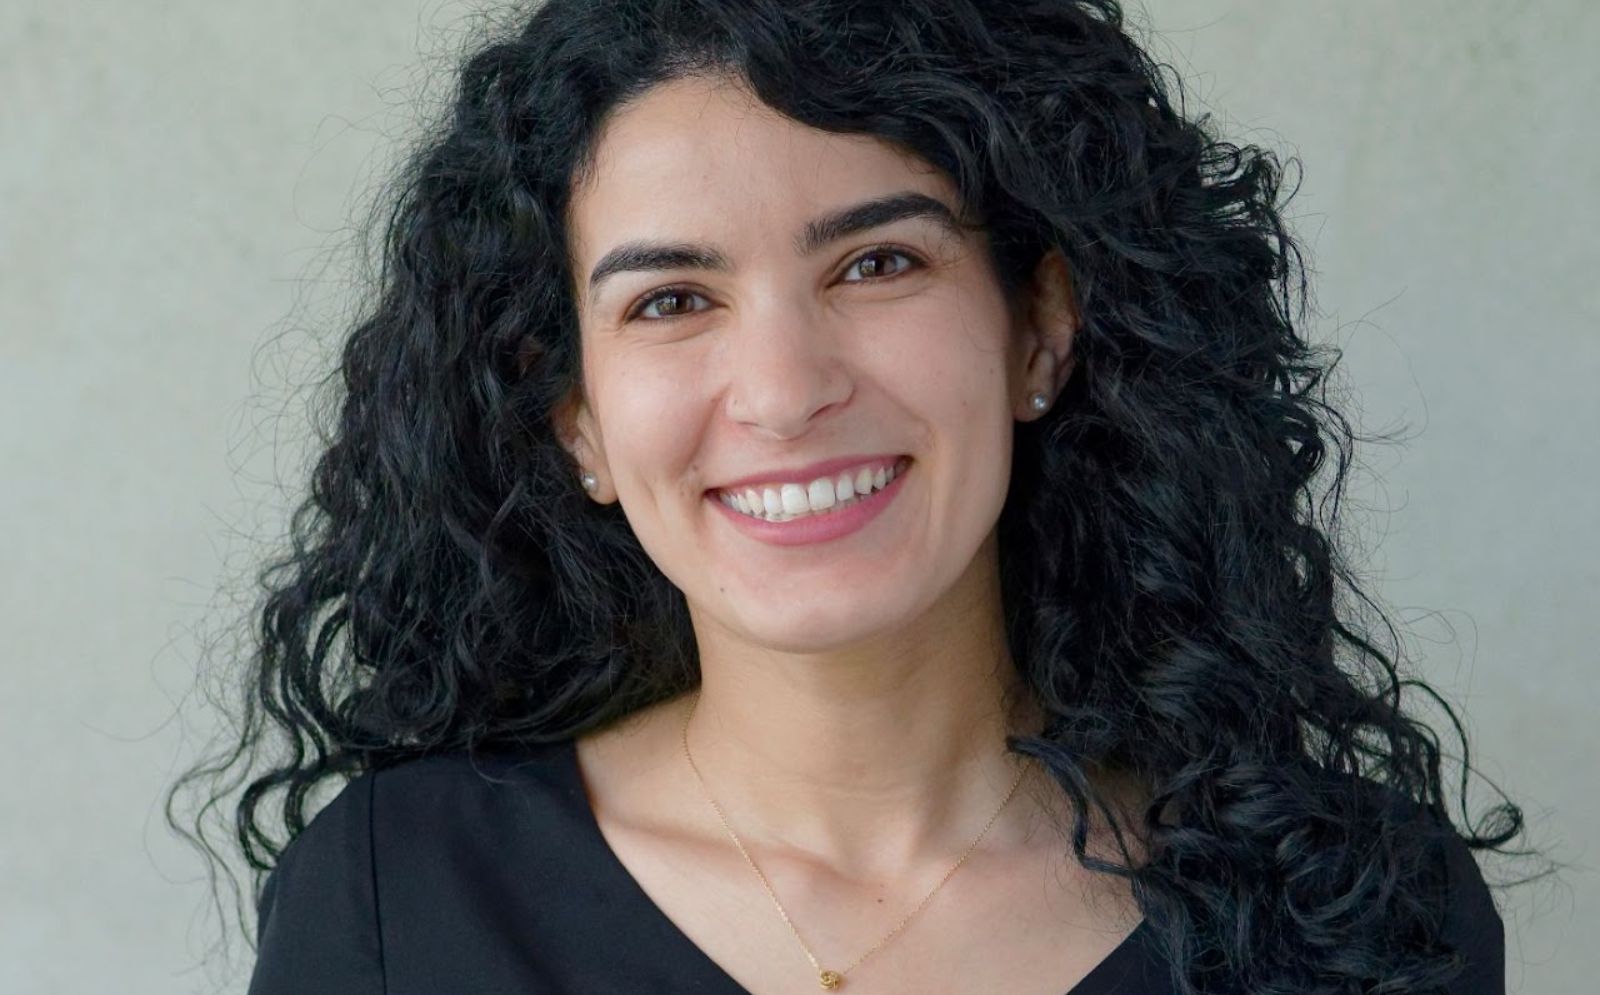
Enseignante-chercheuse au sein de l'équipe RO, Maroua Bahri est spécialisée en apprentissage automatique sur les flux de données, ces ensembles de données qui arrivent continuellement et changent avec le temps.
Q. D’où viens-tu et où vas-tu ?
Je suis Maroua Bahri, maîtresse de conférences à Sorbonne Université et je fais partie de l'équipe RO du LIP6 depuis septembre 2024. J'ai fait ma thèse à Télécom Paris, ensuite j'ai été postdoctorante puis chercheuse SRP au sein d'Inria Paris.
Q. Sur quoi travailles-tu actuellement ?
Le fil conducteur de mes recherches est l'apprentissage automatique sur des flux de données, c’est-à-dire des données qui arrivent continuellement et dont les propriétés peuvent changer avec le temps. C’est le cas par exemple, de données générées par des capteurs, des systèmes IoT, ou des infrastructures distribuées. Dans ce contexte, les méthodes classiques (batch) de l'apprentissage automatique montrent vite leurs limites : on ne peut pas stocker indéfiniment toutes les données ni réentraîner un modèle depuis le début chaque fois que l’environnement change. Il faut donc apprendre en continu, détecter les changements et adapter le modèle avec un coût raisonnable.
C’est ce qui relie plusieurs sujets sur lesquels je travaille. Il s’agit de l’apprentissage automatique pour les flux de données, la détection d’anomalies et l’apprentissage automatique automatisé — Automated machine learning (AutoML). Avec l’AutoML pour les flux de données, par exemple, le système doit apprendre et décider automatiquement quel modèle utiliser et comment le configurer lorsque les données et leurs caractéristiques changent avec le temps, sans intervention humaine constante. Un modèle très bon hier peut devenir mauvais aujourd'hui simplement parce que le monde a changé.
Je m’intéresse aujourd’hui surtout à étendre ces problématiques à des environnements distribués. Les données deviennent de moins en moins centralisées : elles peuvent être générées sur des téléphones, des véhicules, des objets connectés ou sur différents nœuds Edge/Fog/Cloud. On peut donc se demander comment apprendre ensemble à partir de flux distribués sans déplacer toutes les données et sans faire exploser les coûts de communication et de calcul. Cela ouvre plusieurs pistes autour de l’apprentissage fédéré pour les flux de données, de l’ordonnancement proactif des ressources, et de l’utilisation de l’apprentissage automatique lui-même pour décider où, quand, et comment exécuter les calculs.
Q. Comment s’organise ta semaine ?
Comme beaucoup d’enseignants-chercheurs, je n’ai pas vraiment de semaine type. Mon travail se partage entre la recherche, l’enseignement à Sorbonne Université, l’encadrement des étudiants et différentes activités collectives. C’est d’ailleurs l’un des aspects que j’apprécie dans ce métier. Une semaine peut mélanger des cours, des discussions avec des étudiants sur leurs résultats, des réunions avec des collaborateurs, et un moment de réflexion, quand le temps le permet, sur un nouveau problème scientifique. Cette diversité fait circuler les idées entre l’enseignement, la recherche et les collaborations.
Q. Quelle est une chose que les gens ne comprennent pas sur ton sujet de recherche ?
On pense souvent que les progrès en IA reposent sur des modèles plus grands, plus de données, plus de puissance de calcul. Pourtant, dans beaucoup d'environnements réels, les ressources ne sont pas illimitées. Un objet connecté, un équipement Edge ou même un système distribué n’a pas toujours assez de mémoire, de puissance de calcul, de bande passante ou d’énergie pour exécuter en permanence des modèles très coûteux. Et surtout, plus de calcul ne veut pas toujours dire une meilleure solution. Pour moi, l’efficacité ne doit donc pas être vue uniquement comme une contrainte après avoir créé l’algorithme. Elle doit devenir un objectif de conception dès le départ.
Q. Qu’est-ce qui te passionne à propos de ton sujet ?
Au-delà du fait que ce sont des sujets d’actualité, ce qui me passionne, c’est que les problèmes bougent tout le temps. Dans beaucoup de cas, on apprend un modèle à partir d’un jeu de données stable. Mais le monde réel ne fonctionne pas ainsi : les comportements changent, de nouvelles situations apparaissent, les ressources varient, et ce qui était le mieux hier ne l’est pas forcément aujourd’hui. Les LLM en sont un bon exemple. Au-delà de leurs usages connus, je trouve particulièrement intéressant d’explorer comment ils peuvent devenir des outils pour, par exemple, aider à automatiser certaines étapes de conception de nos méthodes. J’aime aussi le côté collaboratif et international de ce domaine. C’est très enrichissant de travailler avec des chercheurs de pays et de cultures scientifiques différents. Cela fait souvent naître des directions que je n'aurais pas eues seule.
Q. Qu’est-ce que tu espères accomplir pendant ton séjour au LIP6 ?
J'aimerais continuer à contribuer au développement de méthodes d'IA plus adaptatives, distribuées et frugales, capables d'apprendre en continu avec le moins de ressources possible. Ce sont des solutions plus adaptées à notre environnement d'aujourd’hui, tout simplement. À moyen/long terme, j'aimerais également obtenir mon HDR, comme une étape naturelle dans la poursuite de mon parcours de recherche et d'encadrement.
Q. Quelque chose à ajouter ?
Toujours avec plaisir pour échanger avec celles et ceux qui s’intéressent à ces sujets ! :)
Contact : Maroua Bahri